Caveman Claude, genauer das Caveman-Skill für Claude Code, zielt auf den sichtbaren Antworttext. Thinking und Tool-Aufrufe kürzt es nicht direkt. In meiner Auswertung von 8.249 Claude-Code-Antworten macht dieser Text nur rund 6,6 Prozent der Ausgabe-Token aus. Selbst bei angenommenen 65 Prozent Kürzung sinken die API-Kosten damit nur um grob 1 bis 2 Prozent. Der Kostenhebel ist gering, den Nutzen sehe ich subjektiv eher beim Lesen.
Ich nutze Claude Code täglich im Abo Max 20x und habe Caveman in der Stufe full in allen interaktiven Sitzungen aktiv. Für diesen Text habe ich meine lokalen Sitzungsprotokolle ausgewertet, Stand 04.10.2026. Eine gemessene Einsparung habe ich nicht, weil mir ein Vergleichsfall ohne Caveman fehlt. Die Daten zeigen aber den direkten Effekt auf den Antworttext.
Was macht Caveman in Claude Code?
Caveman ist ein Open-Source-Projekt für Coding-Agenten, darunter Claude Code. Dieser Artikel behandelt das Caveman-Skill, das Claude anweist, Antworten in knappen Fragmenten ohne Füllwörter zu schreiben. Das Skill zielt auf den sichtbaren Antworttext, den du im Terminal liest. Code, Thinking und Tool-Aufrufe kürzt es nicht direkt. Daneben bietet das Projekt laut README einen Proxy, der Eingaben komprimiert und dabei 33,2 Prozent weniger Input-Token einsparen soll. Diesen Teil behandelt der Artikel nicht.
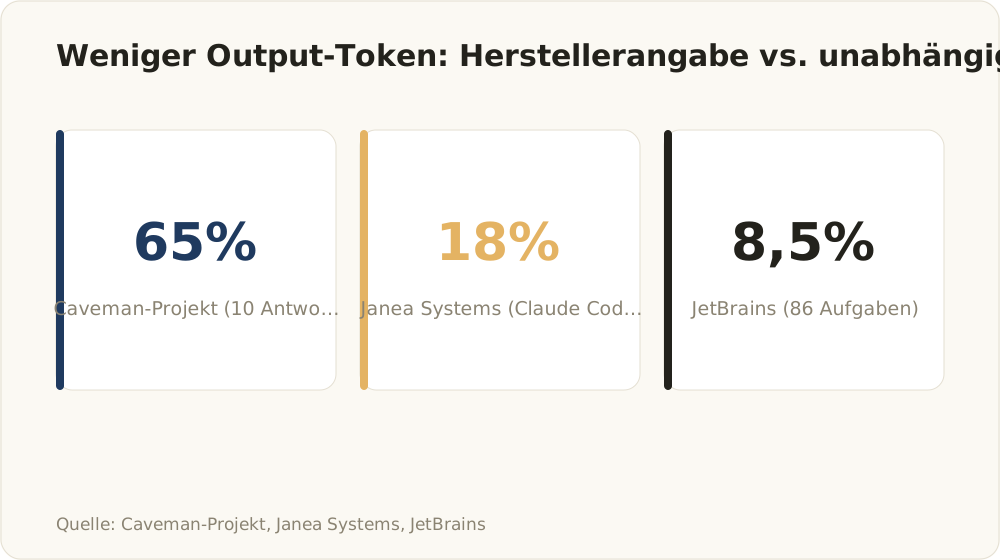
Projektwert aus zehn Einzelantworten (Antworttext), Janea Systems in Claude Code, JetBrains über 86 Aufgaben.
Das Skill bietet mehrere Intensitätsstufen. Ich arbeite durchgehend mit full. Claude Code gehört für mich zu den KI-Tools, die sich im Alltag bewähren. An den Fähigkeiten des Tools ändert Caveman nichts, nur am Ton.
Die Zahl von 65 Prozent weniger Output-Token stammt vom Projekt selbst: Es verglich zehn Einzelantworten, die im Schnitt von 1.214 auf 294 Output-Token sanken. Unabhängige Messungen fallen niedriger aus. JetBrains fand laut InfoWorld über 86 Aufgaben rund 8,5 Prozent weniger Output-Token, nach anfangs etwa 30 Prozent bei den ersten zehn Aufgaben. Eine weitere Messung in Claude Code ergab 18,4 Prozent weniger Token. Dazu kommt: Der 65-Prozent-Wert bezieht sich auf den Antworttext, nicht auf alle Ausgabe-Token.
Was verändert Caveman und was nicht?
Caveman kürzt ausschließlich die Prosa, die du im Terminal liest. Thinking-Tokens und Tool-Aufrufe zählen in Claude Code ebenfalls als Ausgabe-Token, das Skill zielt aber nicht direkt auf sie. Janea Systems beobachtete allerdings, dass Claude Code mit Caveman 17 Prozent weniger Schritte und fast 20 Prozent weniger Tool-Aufrufe machte. Laut der Anthropic-Dokumentation zum Kontextfenster rechnet Anthropic Thinking-Tokens als Output-Tokens ab, und sie zählen zu den Rate Limits.
Die folgende Übersicht zeigt, welche Teile einer Antwort Caveman erreicht:
| Bestandteil | Von Caveman verkürzt? | Als Ausgabe-Token abgerechnet? |
|---|---|---|
| Sichtbarer Antworttext | Ja | Ja |
| Thinking | Nicht direkt | Ja |
| Tool-Aufrufe (Code, Befehle, Dateiänderungen) | Nicht direkt | Ja |
| Code, Befehle, Fehlermeldungen | Nein, bleiben exakt (Herstellerangabe) | Ja |
Kürzere Antworten wirken sich auch auf den Kontext aus. Laut Anthropic geht jede Antwort in den Input des nächsten Turns ein. Die Claude Code Docs zum Kontextfenster halten fest, dass der Kontext Claudes eigene Antworten enthält und dazu Inhalte, die nie im Terminal erscheinen. Weniger Prosa macht den Verlauf also etwas schlanker. Beziffern kann ich diesen Effekt nicht.
Meine Auswertung: Datenbasis, Methode, Kennzahlen
Grundlage sind meine lokalen Claude-Code-Sitzungsprotokolle, Stand 04.10.2026. Ich habe alle interaktiven Sitzungen im Projekt alloqdigital seit dem 10.07.2026 einbezogen. Meine Methode: sichtbaren Antworttext zählen, mit einem Schätzfaktor in Token umrechnen und ins Verhältnis zu allen Ausgabe-Token setzen.
Die Tabelle fasst die Kennzahlen zusammen:
| Kennzahl | Wert |
|---|---|
| Interaktive Sitzungen | 74 |
| Antworten von Claude | 8.249 |
| Ausgabe-Token gesamt | 9,41 Mio. |
| Antworten mit Tool-Aufrufen | 7.131 |
| Reine Textantworten | 1.116 |
| Nicht zugeordnet | 2 |
| Sichtbarer Text | rund 2,16 Mio. Zeichen |
| Sichtbarer Text in Token (Annahme 3,5 Zeichen pro Token) | geschätzt 0,62 Mio. |
| Anteil an den Ausgabe-Token | rund 6,6 Prozent |
| Median einer Textantwort | 1.544 Zeichen |
Nur rund 6,6 Prozent meiner Ausgabe-Token sind Text, den Caveman überhaupt kürzen kann. Der Rest entfällt auf Thinking und Tool-Aufrufe.
Bei reiner Code-Generierung spart Caveman deshalb kaum etwas. Code und Dateiänderungen laufen als Tool-Aufruf, und davon enthalten 7.131 meiner 8.249 Antworten mindestens einen.
Grenzen der Auswertung: kein Vergleichsfall
Meine Zahlen beschreiben einen Ist-Zustand mit Caveman, keinen Vorher-Nachher-Vergleich. Vier Grenzen solltest du kennen:
- Kein Kontrollfall: Alle erhaltenen interaktiven Sitzungen liefen mit Caveman. Ältere Protokolle existieren nicht mehr. Damit gibt es weder eine gemessene Einsparung noch einen A/B-Test.
- Keine Qualitätsquote: Ob Kürze im Modus ultra die Antwortqualität mindert oder zu mehr Rückfragen führt, zeigen meine Daten nicht. Ich nutze nur full.
- Schätzfaktor: Die 3,5 Zeichen pro Token sind eine Annahme. Mischtext mit Pfaden und Code tokenisiert oft dichter, der Textanteil läge dann etwas höher. Auch Claude Code selbst schätzt die Kontextnutzung anhand der Zeichenzahl, wenn Token-Counting-Endpunkte fehlen, so die Claude Code Docs zur Gateway-Kompatibilität.
- Ein Projekt, eine Person: Die Daten stammen aus einem Projekt und aus meiner Arbeitsweise.
Wie viel Token spart Caveman direkt?
Direkt beim Antworttext spart Caveman in meinen Daten unter günstigen Annahmen rund 6 bis 11 Prozent der Ausgabe-Token. Gemessen an den gesamten API-Kosten sind das grob 1 bis 2 Prozent, weil Ausgabe-Token nur einen kleinen Teil der Rechnung ausmachen. Die Verkürzungsrate ist eine Herstellerangabe, nicht meine Messung. Indirekte Effekte wie weniger Tool-Aufrufe oder ein schlankerer Verlauf fehlen und können die Bilanz in beide Richtungen verschieben.
Die Beispielrechnung geht in drei Schritten vor:
- Ausgangslage: 0,62 Mio. Token sichtbarer Text bei 9,41 Mio. Ausgabe-Token, alles mit Caveman.
- Annahme 50 Prozent Kürzung: Ohne Caveman wären rund 0,62 Mio. Token mehr angefallen, etwa 6 Prozent der Ausgabe-Token.
- Annahme 65 Prozent Kürzung: Ohne Caveman wären rund 1,15 Mio. Token mehr angefallen, etwa 11 Prozent der Ausgabe-Token.
Ausgabe-Token machen in meinem September 16 Prozent des API-Äquivalents aus. 6 bis 11 Prozent davon ergeben grob 1 bis 2 Prozent der Gesamtkosten.
In Geld heißt das, wieder als Beispiel: Von rund 3.250 USD API-Äquivalent entfallen etwa 510 USD auf Ausgabe-Token. Überträgt man den Textanteil aus alloqdigital (Juli bis Oktober) grob auf alle Projekte im September, ergibt das brutto rund 30 bis 55 USD, Overhead nicht abgezogen. Der 65-Prozent-Wert des Projekts stammt aus zehn Einzelantworten und bezieht sich auf den Antworttext, nicht auf alle Ausgabe-Token und nicht auf die Gesamtkosten.
Externe Tests zeigen ein gemischtes Bild: Janea Systems maß in Claude Code 18,4 Prozent weniger Token und 24,5 Prozent geringere Kosten, in Codex sank der Tokenverbrauch nur um 3,9 Prozent, und führt die Ersparnis vor allem auf weniger Arbeitsschritte zurück. JetBrains kam dagegen mit Caveman auf höhere Gesamtkosten, weil eine einzelne Aufgabe als Ausreißer die Long-Context-Preisstufe der Anthropic-API überschritt. Meine Hochrechnung ersetzt also keinen Vergleichstest.
Wo fallen in Claude Code wirklich Token an?
Der Großteil der Kosten in Claude Code entsteht beim Input, nicht bei der Ausgabe. In meinen Daten aus dem September 2026 entfallen rund 85 Prozent des API-Äquivalents auf Cache-Lesen und Cache-Schreiben, nur 16 Prozent auf Ausgabe-Token. Den Token-Verbrauch von Claude Code senkst du deshalb vor allem beim Kontext.
Die Tabelle zeigt die Kostenstruktur über alle Projekte auf meinem Rechner, berechnet mit den API-Listenpreisen von Anthropic, Stand 04.10.2026:
| Posten | Anteil | API-Äquivalent (gerundet) |
|---|---|---|
| Cache-Lesen | 52 % | rund 1.680 USD |
| Cache-Schreiben | 33 % | rund 1.060 USD |
| Ausgabe-Token | 16 % | rund 510 USD |
| Gesamt | 100 % | rund 3.250 USD |
Ich zahle einen Pauschalpreis für Max 20x. Die 3.250 USD sind eine Rechnung, keine Abrechnung. Ob kürzere Antworten im Abo mehr Spielraum im 5-Stunden-Fenster oder beim Wochenlimit schaffen, kann ich nicht belegen.
Laut Anthropic zählen im Kontextfenster Systemprompt, alle Nachrichten inklusive Tool-Ergebnissen und die Tool-Definitionen mit. Mit Prompt Caching verteilt sich der Input auf input_tokens, cache_read_input_tokens und cache_creation_input_tokens. MCP-Server sind ein Praxisbeispiel für viel Tool-Kontext, etwa wenn du Google Ads mit Claude per MCP auswerten willst.
Auch Caveman selbst kostet Input. Laut Claude Code Docs laden Skill-Beschreibungen schon vor deiner ersten Eingabe in den Kontext. Nach einer Komprimierung fügt Claude Code aufgerufene Skills erneut ein, begrenzt auf 5.000 Token pro Skill und 25.000 Token insgesamt, die ältesten Skills fallen zuerst weg. Den Overhead von Caveman habe ich nicht gemessen. Das Projekt schreibt in seiner HONEST-NUMBERS.md selbst, dass die zusätzlichen Input-Kosten von den geladenen Regeln und vom Cache-Verhalten abhängen und dort nicht gemessen wurden. Seine Empfehlung: Vergleiche die abgerechneten Gesamtkosten für dieselbe Aufgabe mit und ohne Caveman, und schalte es für Arbeit ab, bei der es die Kosten erhöht. Meine Rechnung zieht diesen Overhead nicht ab.
Ein kleiner Kontext hilft auch der Qualität. Anthropic beschreibt, dass Genauigkeit und Erinnerungsleistung mit wachsender Tokenzahl abnehmen, das sogenannte Context Rot. Prompt Caching, Modellwahl und Kostendetails behandelt der Artikel dazu, was Claude wirklich kostet.
Wann lohnt sich Caveman und wann nicht?
Meine Rechnung zeigt einen geringen Kostenhebel. Den Nutzen sehe ich eher beim schnelleren Lesen, das ist aber mein subjektiver Eindruck. Laut meiner Beispielrechnung liegt die Kostenwirkung bei grob 1 bis 2 Prozent, externe Tests kommen zu abweichenden Ergebnissen. Für Texte, die andere Menschen ohne Kontext verstehen müssen, schaltest du Caveman besser ab.
Für die Entscheidung nutze ich die Wer-liest-es-Regel mit drei Kriterien:
- Du liest die Antwort selbst und kennst die Aufgabe: Caveman an. Ich lese kürzere Antworten subjektiv schneller.
- Die Antwort geht an Kundschaft, Teammitglieder oder in eine Erklärung ohne Vorwissen: Caveman aus.
- Code, Befehle und Fehlermeldungen: Laut Herstellerangabe lässt das Skill diese Inhalte ohnehin exakt unverändert.
Ob Caveman mehr bringt als eine einfache Kürze-Anweisung in der CLAUDE.md, habe ich nicht verglichen. Das Projekt hat es selbst gegen eine schlichte “Be concise”-Anweisung getestet: Auf claude-opus-5-5 kürzte die Standardstufe die Ausgabelänge im Median um 3 Prozent, die Stufe ultracave um 35 Prozent (zehn Prompts, ein Durchlauf, nur die Länge der Ausgabe). Das ist eine Herstellermessung mit kleiner Stichprobe. Die CLAUDE.md lädt laut Claude Code Docs ohnehin vor jeder Sitzung in den Kontext, ein Skill kommt zusätzlich dazu.
Caveman einrichten: kurz und nach README
Die Einrichtung folgt dem README des Projekts (Stand 04.10.2026). Für Claude Code nennt es diesen Befehl:
npx skills add JuliusBrussee/caveman -gAktivieren kannst du den Modus laut README mit /caveman, die Intensität wechselst du mit /ultracave oder /megacave, und mit dem Satz “stop caveman” schaltest du ihn wieder ab. Die Stufennamen hängen von der Version ab: In meiner Installation heißen sie lite, full und ultra, ich arbeite mit full. Das Projekt gibt an, dass Code, Befehle, Pfade und Fehlermeldungen unverändert bleiben und deine eigenen Eingaben nie umgeschrieben werden.
Ich setze Caveman ausschließlich in der Claude Code CLI ein. Ob es in Cowork oder Claude.ai funktioniert, habe ich nicht getestet.
Häufige Fragen
Spart Caveman wirklich Token?
Ja, aber nur beim sichtbaren Antworttext. In meinen 8.249 Claude-Code-Antworten macht dieser Text rund 6,6 Prozent der Ausgabe-Token aus. Auf Thinking und Tool-Aufrufe zielt das Skill nicht direkt. Eine gemessene Einsparung habe ich nicht, weil alle erhaltenen Sitzungen mit Caveman liefen und mir damit ein Vergleichsfall fehlt.
Wie viel spart Caveman an Kosten?
Als Rechenbeispiel: Bei angenommenen 50 bis 65 Prozent Kürzung des Antworttexts spart Caveman 6 bis 11 Prozent der Ausgabe-Token. Da Ausgabe-Token in meinem API-Äquivalent nur 16 Prozent der Kosten ausmachen, sinken die Gesamtkosten um grob 1 bis 2 Prozent. Die Kürzungsrate ist eine Annahme, keine Messung.
Gilt Caveman auch für Code?
Nicht direkt. Code in Tool-Aufrufen kürzt das Skill nicht, externe Tests deuten aber auf weniger Tool-Aufrufe hin. In meinen Daten enthalten 7.131 von 8.249 Antworten solche Tool-Aufrufe, dort gibt es wenig Prosa zum Kürzen. Laut Herstellerangabe im GitHub-Repo lässt Caveman außerdem Code, Befehle und Fehlermeldungen exakt unverändert.
Beeinflusst Caveman die Antwortqualität?
Belegen kann ich das in keine Richtung. Meine Auswertung enthält keine Qualitätsquote und keinen Vergleich ohne Caveman, und ich nutze nur die Stufe full. Ob ultra mehr Rückfragen erzeugt, zeigen meine Daten nicht. Für Texte an Dritte ohne Kontext schalte ich Caveman trotzdem ab, weil knappe Fragmente dort Vorwissen voraussetzen.
Wie installiere ich Caveman?
Laut README des Projekts mit npx skills add JuliusBrussee/caveman -g, danach aktivierst du es in Claude Code mit /caveman. Die Stufennamen unterscheiden sich je nach Version, in meiner Installation sind es lite, full und ultra. Ich nutze Caveman ausschließlich in der Claude Code CLI und habe andere Umgebungen nicht getestet.
Wie schalte ich Caveman aus?
Laut README genügt der Satz “stop caveman”, dann antwortet Claude wieder normal. Sinnvoll ist das immer dann, wenn eine Antwort an Kundschaft oder Teammitglieder geht oder als Erklärung ohne Vorwissen funktionieren muss. Für deine eigene Arbeit im Terminal kannst du es aktiv lassen.
Mein Rat für die nächste Sitzung: Prüfe zuerst, wie viel deines Kontexts auf Tool-Ergebnisse, Verlauf und Cache entfällt, und kürze dort. Caveman schaltest du danach für die Lesbarkeit dazu.